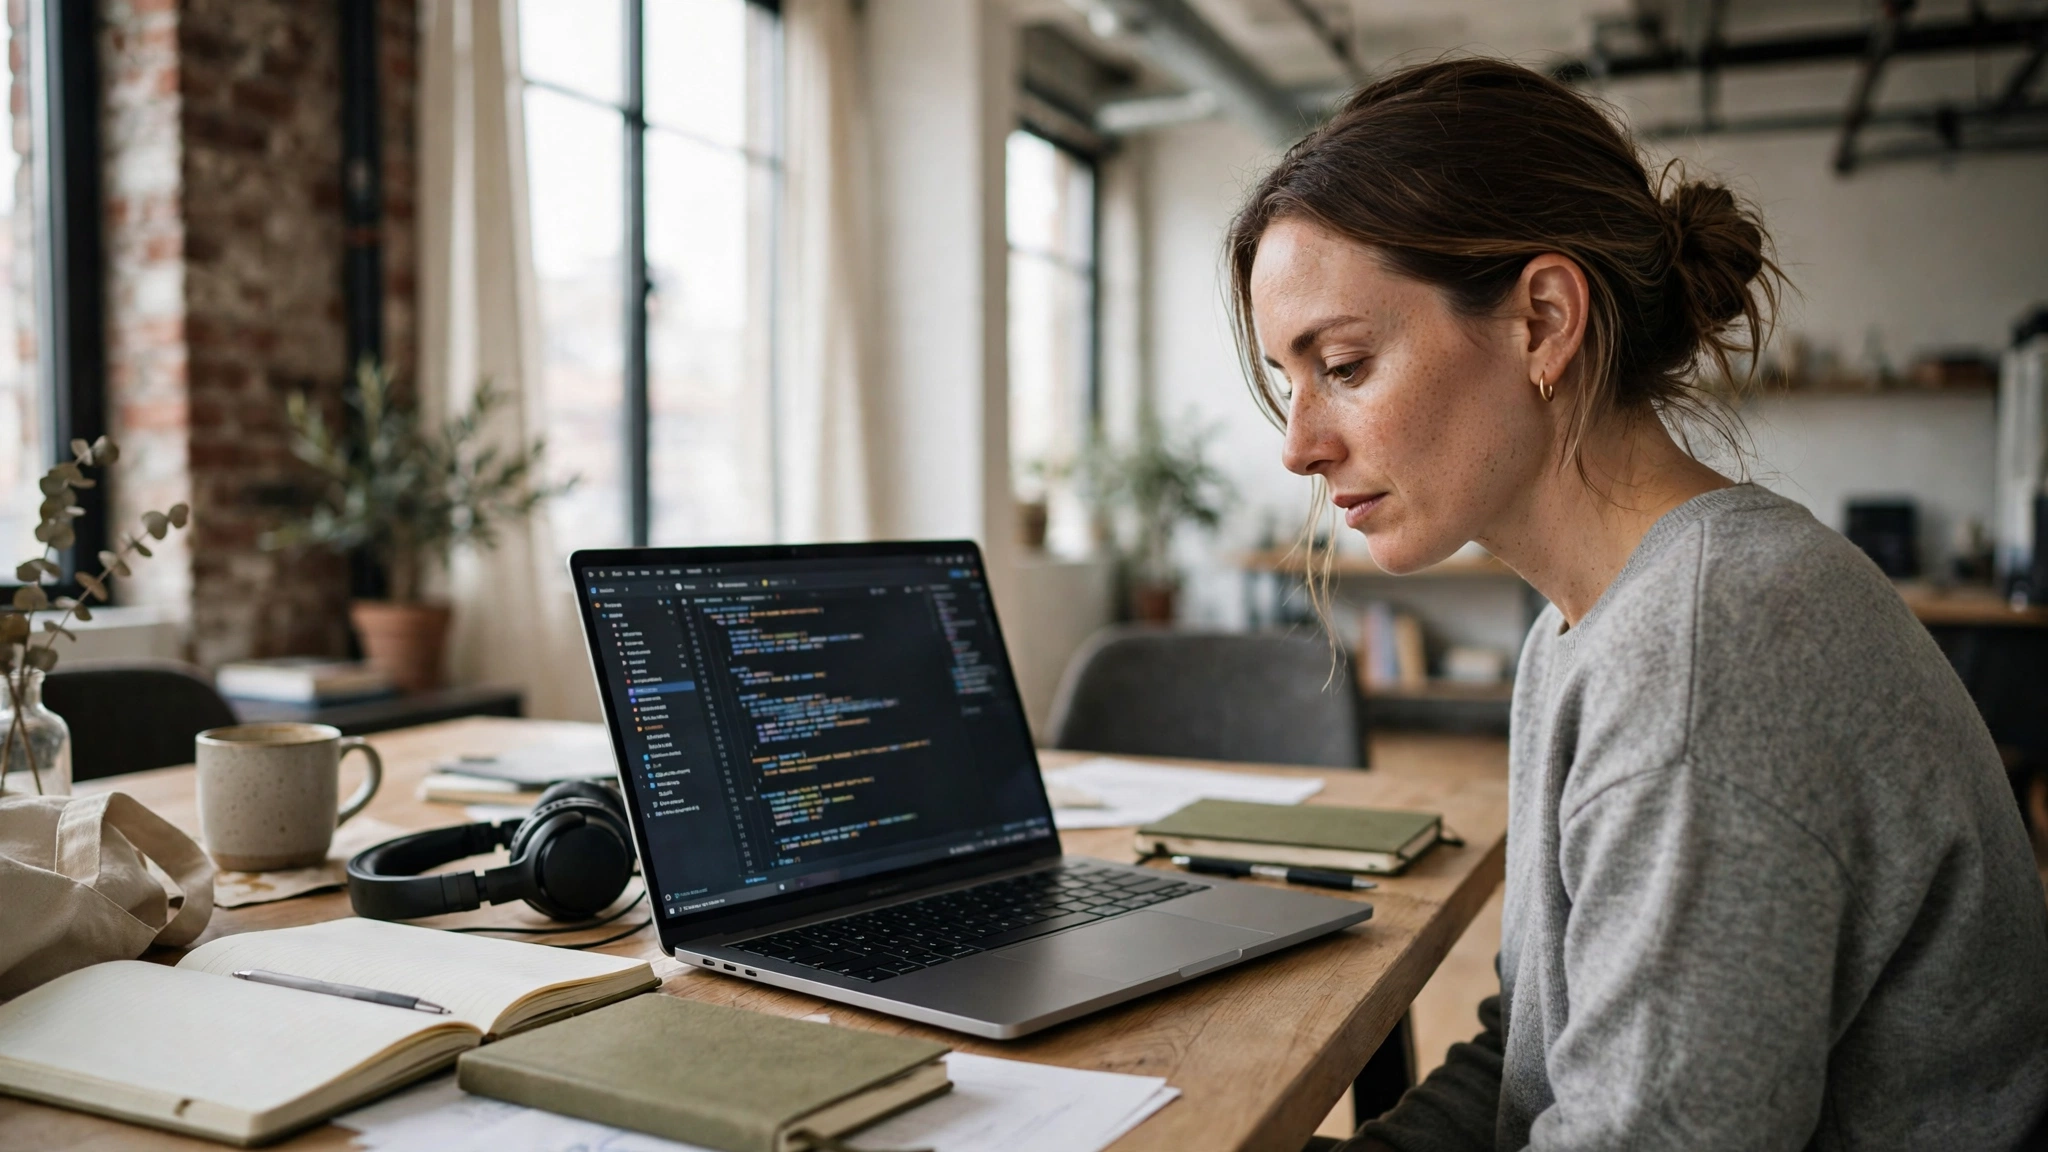
La laptop de tu escritorio acaba de volverse mucho más ambiciosa. El 28 de octubre, NVIDIA anunció que sus laptops RTX Spark ya están disponibles con seis fabricantes, ASUS, Dell, HP, Lenovo, Microsoft y MSI, con configuraciones de 128 GB desde 2599 dólares. No son máquinas de juego con una etiqueta de IA pegada en la caja. Cada una combina un procesador gráfico Blackwell RTX con un procesador central Grace en un único superchip, con hasta 128 GB de memoria unificada compartida y hasta 1 petaflop de rendimiento de IA en FP4.
Conviene leer esa ficha despacio. Un petaflop, en una laptop. Algunos diseños tienen apenas 14 mm de grosor y un peso de unas tres libras, con una autonomía que NVIDIA describe como de todo el día. Hace un año o dos, ejecutar un modelo serio en local significaba una torre bajo el escritorio, un ventilador ruidoso y una fuente de alimentación con carácter. Ahora esa misma clase de trabajo cabe en el equipaje de mano.
Un solo fondo de memoria, sin malabares
La memoria unificada es aquí la estrella discreta. Las aplicaciones creativas y los modelos de IA toman recursos del mismo fondo de 128 GB, de modo que un editor de vídeo puede mantener abierta una línea de tiempo mientras un modelo local transcribe, traduce o redacta en segundo plano. Sin trasladar archivos entre bancos de memoria separados. Sin esperar una cola de subida antes de que empiece la parte inteligente.
NVIDIA añadió además un control práctico que los usuarios que trabajan apreciarán. Una nueva función de gestión de recursos en la aplicación de NVIDIA permite decidir cómo se reparte la capacidad de la GPU entre la aplicación en primer plano y los agentes que se ejecutan detrás. Basta activar la programación de GPU acelerada por hardware en los ajustes de Windows, abrir Sistema Avanzado en la aplicación y fijar el equilibrio a tu gusto. Tu hoja de cálculo mantiene su velocidad. Tu agente en segundo plano mantiene su tarea. Todo se comporta, en la misma línea de utilidad que muestran proyectos como el dron ligero pensado para vigilar más de 130 millas.
Un modelo abierto de voz que cumple
El titular de software es Nemotron 3.5 Transcribe, un nuevo modelo abierto de voz publicado el mismo día. Un solo modelo adaptable por instrucciones se encarga de la transcripción, la identificación de hablantes y la traducción, y puede responder preguntas sobre el audio grabado. Transcribe 40 idiomas, incluidos siete idiomas índicos. NVIDIA afirma que ocupa el puesto número 1 en la clasificación Open ASR de Hugging Face y el número 2 entre los modelos abiertos en Artificial Analysis.
La cifra de eficiencia importa tanto como las clasificaciones. El modelo funciona con unos 4300 millones de parámetros activos, aproximadamente un 80 por ciento menos que su principal rival abierto, según NVIDIA. Menos parámetros activos significa menos cálculo por respuesta, justo lo que quiere escuchar el chip de una laptop. El modelo ya está disponible en Hugging Face y se prevén versiones cuantizadas para que los desarrolladores puedan ejecutarlo en local en sistemas RTX Spark y DGX Spark, en dispositivos Jetson AGX Thor o escalarlo en hardware Blackwell de centro de datos.
Imagina un pequeño equipo de producción después de una grabación. Horas de entrevistas llegan a una sola laptop. Para cuando aparece el segundo café, el audio ya está transcrito, los hablantes están etiquetados, las respuestas clave están traducidas y un editor puede hacerle una pregunta directa a la grabación: ¿dónde mencionó el presupuesto? Eso no es un truco de demostración. Es una tarde de martes, acortada. Ese salto de productividad recuerda al de los camiones sin conductor que ya cubren rutas del sur: menos espera, más trabajo terminado.
Los modelos abiertos tienen asiento desde el primer día
RTX Spark también se lanzó con soporte desde el primer día para LFM3, la familia de modelos abiertos de Liquid AI que abarca texto, visión, audio y tareas de decisión sobre una misma base compartida. El nuevo modelo base de 1700 millones de parámetros supera al anterior modelo base de 2600 millones de la compañía, según NVIDIA, y la familia funciona en local mediante llama.cpp y vLLM, con ajuste fino en la propia máquina. Más pequeño, mejor, local. Ese patrón se repite esta semana y conversa bien con lecturas como los pop-ups neoyorquinos de esta semana, donde lo compacto y bien pensado gana espacio.
El juego también vino en el viaje
Creadores y desarrolladores son el mensaje principal, pero las personas que juegan no quedaron olvidadas. Phantom Blade Zero, de S-GAME, se lanzó el 28 de octubre a las 7 p. m. hora del Pacífico en Steam y Epic Games Store con efectos de trazado de rayos creados con NVIDIA y DLSS 4.5 con generación dinámica de fotogramas. RTX Remix 1.6 puede renderizar Minecraft Java Edition 1.21.1 con trazado de caminos, y DLSS 5 con renderizado neuronal guiado en 3D ya es compatible con RTX Spark en Portal with RTX y en la demostración de Half-Life 2 RTX.
Por qué la IA local gana adeptos
Hay un atractivo sencillo en un modelo que vive en tu propia máquina. Tus grabaciones se quedan en tu disco. Tus borradores se quedan en la habitación. El trabajo continúa en un tren, en un estudio o en cualquier lugar donde la conexión flojea. Los servicios en la nube conservan su lugar para los trabajos más grandes, y NVIDIA también vende mucho de ese hardware, pero la actualización del 28 de octubre defiende con claridad que la laptop ya es una computadora de IA de primera clase, no una terminal fina para el centro de datos de otra persona.
Consejos prácticos si estás comprando o creando: ajusta la memoria a los modelos que realmente ejecutas, porque la configuración de 128 GB es la que desbloquea el trabajo local grande. Comprueba que tus herramientas de transcripción y de agentes admiten los nuevos controles de recursos antes de depender de ellos en una semana de entregas. Y si la voz es tu cuello de botella, prueba Nemotron 3.5 Transcribe primero con una grabación real de una reunión: 40 idiomas y etiquetas de hablante son afirmaciones fáciles de comprobar, y la prueba lleva diez minutos. Seis marcas en las tiendas, un modelo abierto de voz en lo alto de su clasificación y un petaflop que cabe en una mochila. El 28 de octubre fue un buen día para quienes prefieren su IA cerca.
También publicado en:
- News Today World – https://newstodayworld.org/breaking-news/2026/10/29/prince-mario-max-schaumburg-lippe-rtx-spark-laptops-bring-a-petaflop-of-local-ai-to-six-brands/
- Revista Minutos – https://revistaminutos.com/las-laptops-rtx-spark-llevan-un-petaflop-de-ia-local-a-seis-marcas/
- Billionaire Herald – https://billionaireherald.com/a-petaflop-in-a-backpack-reprices-the-premium-laptop/
- The American Newsroom – https://theamericannewsroom.com/six-laptop-brands-put-serious-ai-power-in-a-backpack/
- Le Miroir Francais – https://lemiroirfrancais.com/les-portables-rtx-spark-offrent-un-p-taflop-d-intelligence-artificielle-locale-c/

Sé el primero en comentar