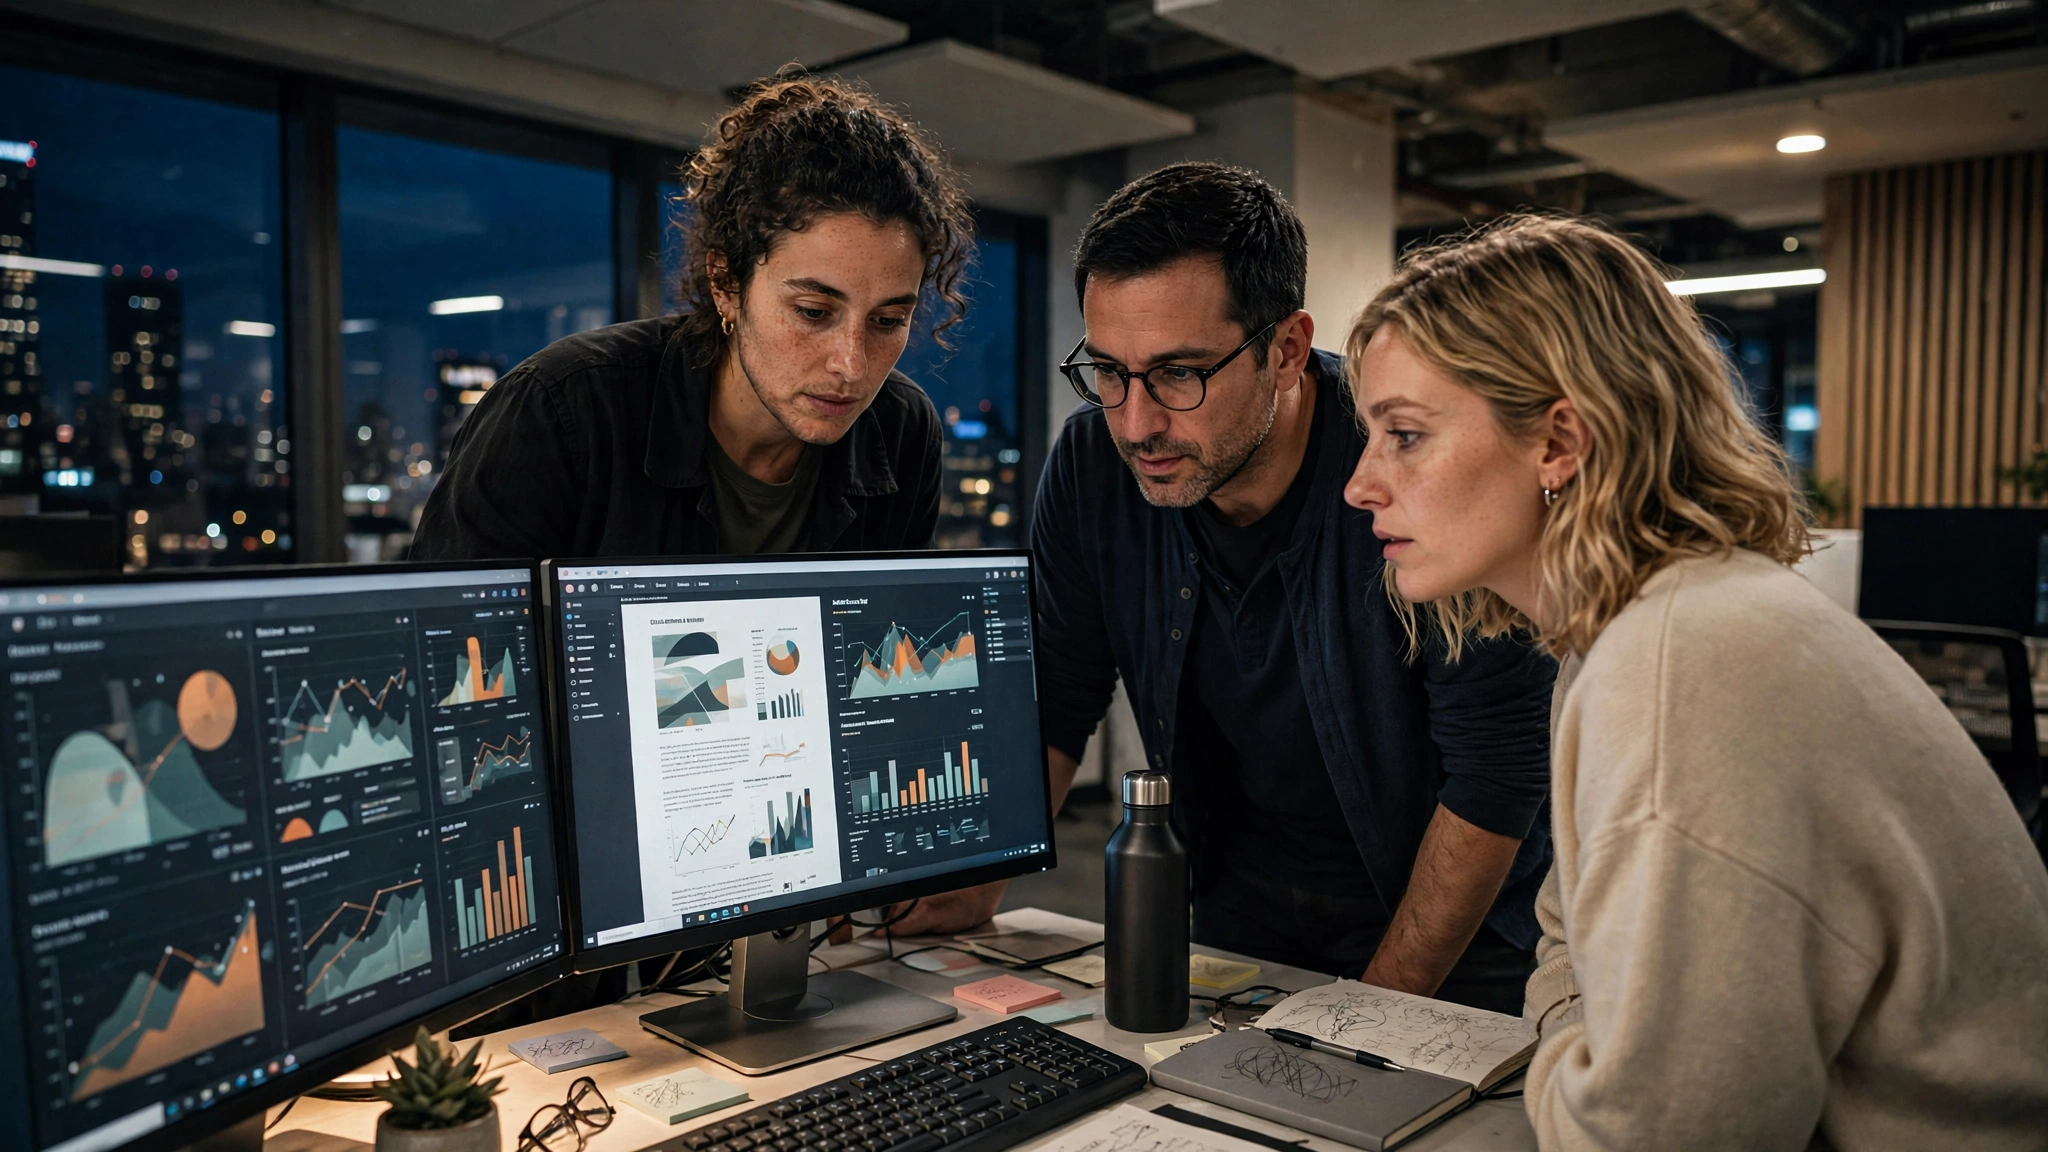
Casi toda la IA de oficina todavia vive en otro sitio. Subes un contrato, esperas a que un servidor remoto lo lea y confias en que el archivo se mantenga privado por el camino. NVIDIA quiere cambiar ese habito. El 15 de octubre de 2026, la empresa publico Nemotron 3.5 Super VL como modelo abierto, lo subio a Hugging Face ese mismo dia y lo explico con claridad: esta pensado para agentes que permanecen activos, completan pasos por su cuenta y trabajan cerca de donde ocurre el trabajo real.
Esa cercania importa. Un modelo que puede vivir en una sola estacion de trabajo cambia quien controla los documentos, los tiempos y el coste. Para un despacho con archivos de clientes, una clinica con formularios de admision o un equipo financiero con extractos que no puede enviar fuera, lo local no es una preferencia tecnica. Es el motivo principal.
Un modelo grande que solo usa una parte de si mismo
Nemotron 3.5 Super VL tiene 120.000 millones de parametros en total, pero solo unos 12.000 millones estan activos por cada token que procesa. Eso es el diseno de mezcla de expertos en la practica. En lugar de despertar toda la red para cada palabra, el modelo envia el trabajo a los expertos que necesita en ese paso. Obtienes el beneficio del conocimiento de un modelo grande sin pagar la factura completa de computo en cada pasada.
Las siglas VL significan vision y lenguaje, y el alcance es amplio. El modelo lee texto, imagenes, video corto y archivos PDF, con una ventana de contexto declarada de 1 millon de tokens. Un millon de tokens no es solo un numero bonito para un titular. En el dia a dia significa que un informe largo, una pila de paginas escaneadas y las notas que las acompanan pueden quedarse en la misma conversacion. El agente no tiene que olvidar la pagina 12 cuando llega a la 80.
NVIDIA enumera los trabajos objetivo con claridad: seguir instrucciones, usar herramientas, flujos empresariales en varios pasos, comprension visual, proceso de documentos, programacion e investigacion. Al leer esa lista se ve un patron. Ninguno de esos trabajos es una pregunta y una respuesta. Son cadenas: lee esto, comprueba aquello, abre el otro archivo, redacta el resumen y marca lo que no coincide. Eso es justo lo que un agente siempre activo deberia hacer mientras una persona sigue con otras tareas.
Lo que NVIDIA afirma sobre la velocidad
Las cifras de rendimiento necesitan una fuente, y aqui la fuente es la propia NVIDIA. La empresa dice que Nemotron 3.5 Super VL ofrece hasta 5 veces mas rendimiento que modelos abiertos comparables de su clase en una sola GPU. Tambien afirma que iguala a su mayor modelo de razonamiento, con cerca de una quinta parte de parametros, en tareas especializadas. Son afirmaciones de la empresa recogidas en la cobertura del lanzamiento, no resultados de un laboratorio independiente, y conviene tratarlas asi: interesantes, concretas y pendientes de prueba en cada instalacion.
Aun con esa cautela, la direccion esta clara. Si una huella activa mas pequena puede hacer bien el trabajo especializado, mas equipos podran permitirse tener un agente activo todo el dia, en lugar de alquilar rafagas de computo para trabajos grandes. Eso abre la puerta a empresas pequenas, no solo a grandes corporaciones con sus propios conjuntos de servidores.
Dos modelos Bolt para equipos mas pequenos
Super VL no llego solo. NVIDIA tambien puso a disposicion ese dia Nemotron 3.5 Bolt 74B-A9B 24GB. Tiene 74.000 millones de parametros, con 9.000 millones activos, y usa compresion nativa de 2 bits para caber en 24 GB de memoria. NVIDIA lo probo en un PC con GeForce RTX 5090 y en DGX Spark. En palabras llanas, hablamos de un ordenador de sobremesa de gama alta y de un sistema compacto de IA de escritorio, no de una fila de un centro de datos.
Un tercer modelo llega muy pronto. Nemotron 3.5 Bolt E4B 4GB, pensado para el borde de la red y para dispositivos, esta previsto para el 23 de octubre de 2026. Con 4 GB, la conversacion pasa del despacho al aparato: una tableta de trabajo en campo, una unidad en una fabrica, un terminal de punto de venta que necesita entender un formulario o una foto sin una conexion constante a la nube.
Tres tamanos, una familia y una idea. Poner el tamano adecuado en el sitio adecuado para que el agente se quede con la tarea, en lugar de esperar a la red. Es un enfoque que tambien se reconoce en otras propuestas ambiciosas de movilidad y tecnologia que hemos contado, como el coche volador que quiere conquistar el cielo de las ciudades.
Pesos abiertos, uso comercial y eleccion real
La licencia importa tanto como las pruebas de rendimiento. Nemotron 3.5 se publica bajo OpenMDW-1.1, que permite el uso comercial, segun la informacion del lanzamiento. Los pesos estan disponibles en Hugging Face, NIM, OpenRouter y ModelScope. Para una empresa, eso significa poder probar el modelo, ajustarlo con sus propios documentos e integrarlo en un producto sin empezar por una negociacion de licencias.
Tambien significa que las comparaciones se vuelven honestas y rapidas. Cualquiera puede ejecutar los pesos abiertos, medirlos y someterlos a pruebas exigentes. Si las cifras de rendimiento se cumplen con los contratos de un equipo legal o con las fotos de producto de un comercio, la gente lo dira. Si no se cumplen en una tarea concreta, tambien se sabra. Los lanzamientos abiertos invitan a esa comprobacion, y el sector sale ganando.
Consejos practicos para equipos que valoran un agente local
Empezad con documentos que ya moveis cada semana. Facturas, PDF de admision, casos de soporte con capturas, paquetes de investigacion: elegid un flujo con un inicio y un final claros. Usad Super VL si necesitais todo el alcance multimodal y el contexto largo, o empezad con Bolt 24GB si el limite es la memoria de vuestra estacion. Mantened a una persona revisando el resultado durante las primeras semanas y registrad donde duda el agente. Esos registros dicen si hace falta un modelo mayor, mejores instrucciones o archivos de origen mas limpios.
Prestada atencion tambien a las ventajas de privacidad que se pueden medir. Cuantos archivos dejan de salir del edificio. Cuantas horas de copiar y pegar desaparecen. Esos numeros convencen a un responsable mas rapido que cualquier grafica de rendimiento, igual que una buena planificacion convence en propuestas tan distintas como los planes de un viernes en Nueva York.
NVIDIA publico estos modelos el 15 de octubre, y el momento parece deliberado. Los agentes pasan de las demostraciones al trabajo diario, y el trabajo diario ocurre en mesas, en oficinas traseras y en dispositivos que no siempre pueden llamar a casa. Un modelo abierto de 120.000 millones de parametros que activa solo una parte de si mismo, lee video y PDF y tiene dos hermanos Bolt mas pequenos para hardware ajustado da a los equipos una opcion real para mantener ese trabajo en local. Es un paso util y concreto, y para las oficinas que esperaban para probar agentes hasta poder controlar sus propios archivos, quiza sea el paso que por fin tenga sentido.

Sé el primero en comentar