Los modelos grandes suelen llegar con restricciones grandes. El equipo inclusionAI de Ant Group ha ido en direccion contraria. El 27 de octubre de 2026 publico en Hugging Face el modelo Ling-3.1-flash-1019 bajo una licencia MIT sencilla, una de las mas abiertas del mundo del software. Dos dias antes habia aparecido el modelo base preentrenado, Ling-3.1-flash-base, tambien bajo MIT.
La escala es el titular. Ling-3.1-flash suma 560.000 millones de parametros en total, con unos 25.000 millones activos por cada token que procesa. Segun el material de lanzamiento, es el primer modelo con licencia MIT de esta escala procedente de un grupo financiero chino. Ant Group es la empresa que esta detras de Alipay, e inclusionAI es su laboratorio en Hangzhou.
Una licencia MIT a este tamano cambia quien puede hacer que. Los investigadores pueden inspeccionarlo. Las empresas emergentes pueden construir sobre el. Las companias pueden ejecutarlo dentro de sus propias instalaciones y mantener alli sus datos. Sin permisos especiales y sin condiciones estrechas de uso solo para investigacion.
Como 560.000 millones de parametros resultan asequibles de ejecutar
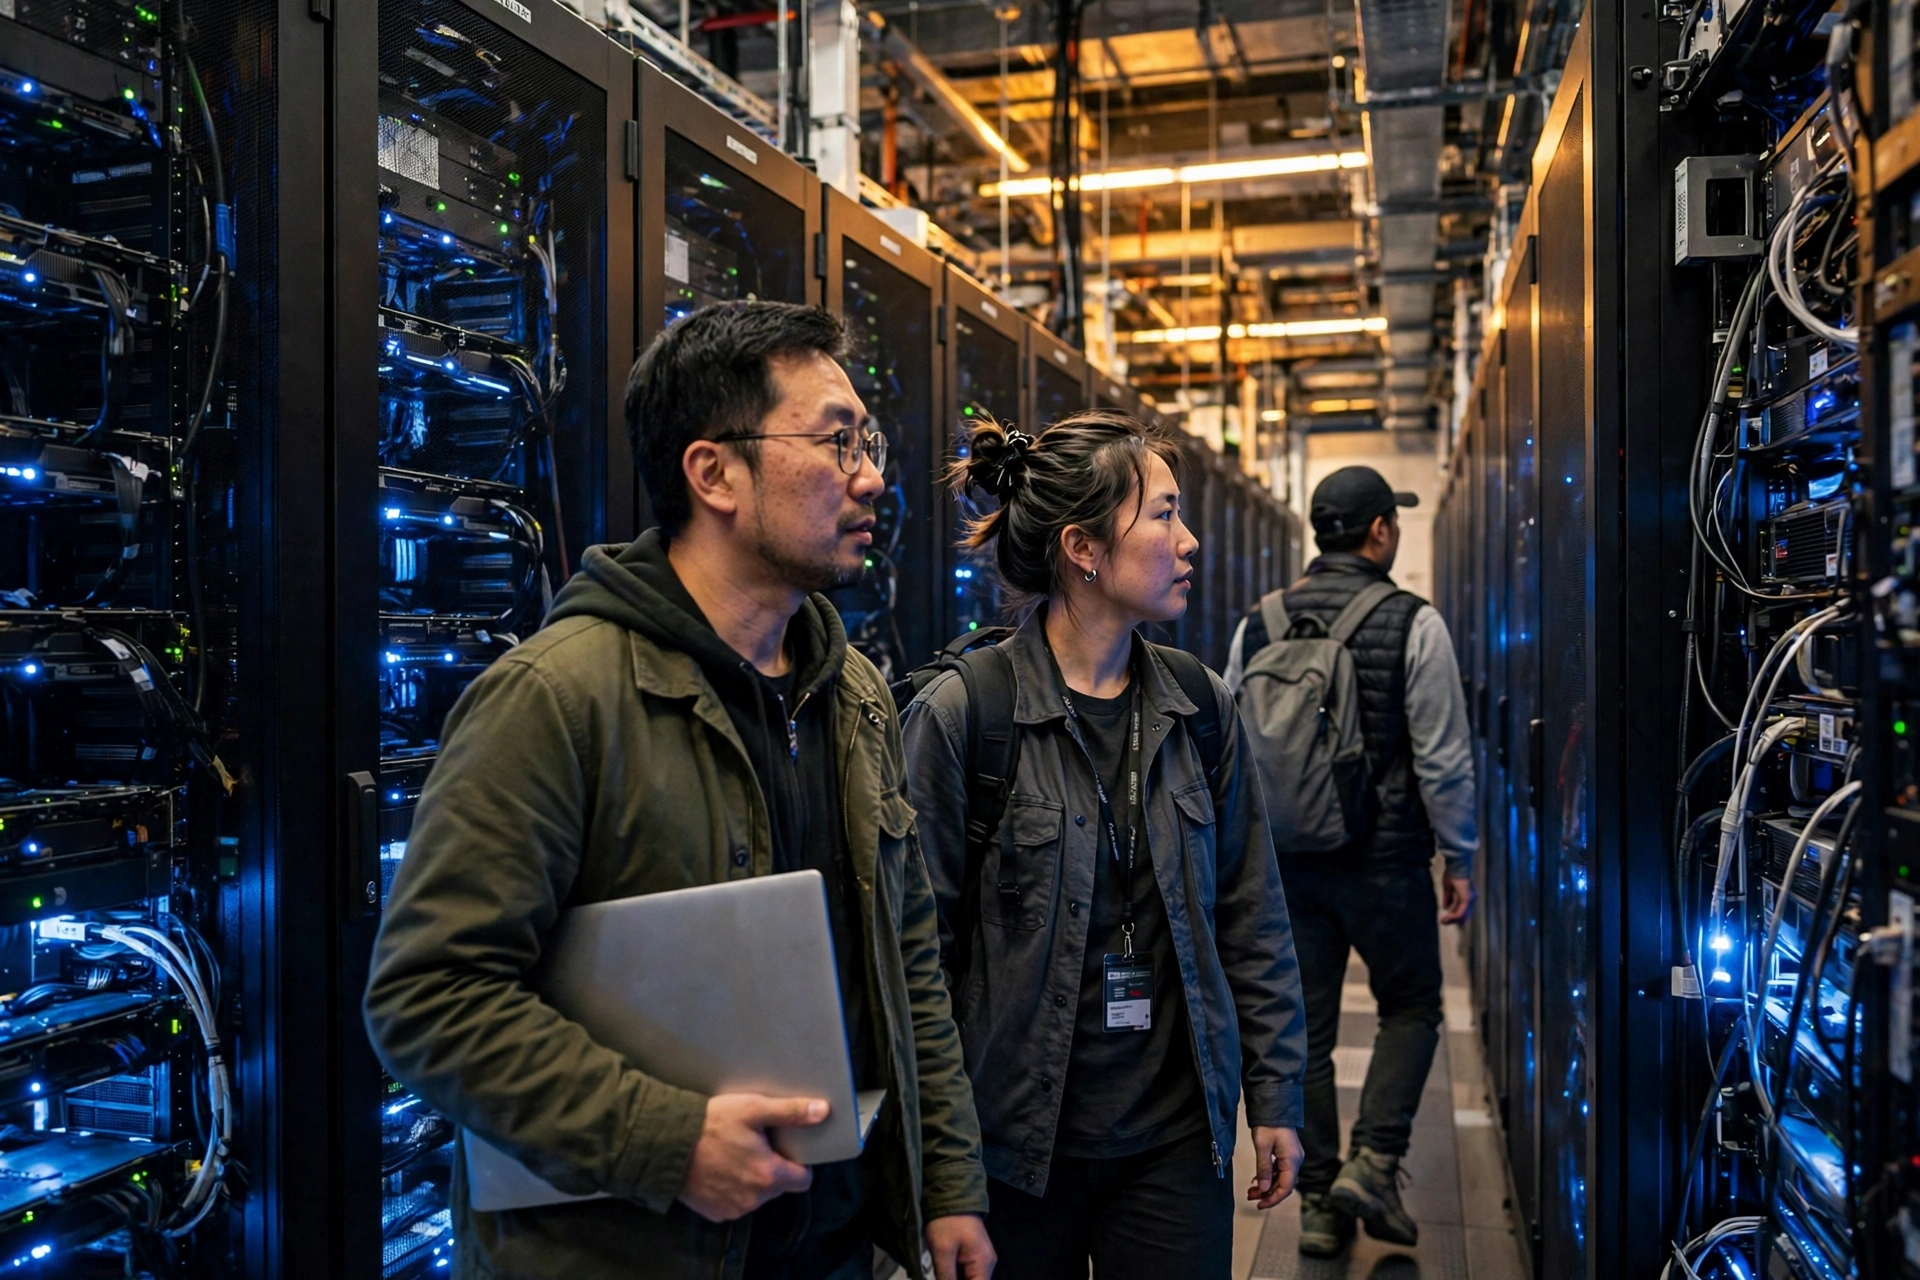
El truco es un diseno de mezcla de expertos, conocido como MoE. El modelo alberga 512 expertos enrutados, y para cada token se activan 8 de ellos, mas un experto compartido que participa siempre. Piensen en un gran hospital: cientos de especialistas trabajan en el edificio, pero cada caso lo atiende un equipo pequeno elegido segun los sintomas. Se obtiene la profundidad de toda la institucion sin pagar porque cada medico asista a cada consulta.
Por eso la cifra activa importa mas que la total. Unos 25.000 millones de parametros activos por token representan el coste de trabajo de cada paso, mientras que los 560.000 millones totales son la biblioteca de la que el modelo puede echar mano. Los equipos que presupuesten la inferencia deberian planificar en torno a la cifra activa, mas la memoria necesaria para alojar el modelo completo, que es donde entran las notas de hardware de mas abajo.
La arquitectura de atencion es poco habitual y merece atencion. Combina 63 capas de atencion lineal KDA con 9 capas de Gated MLA, una proporcion de 7 a 1. La mayoria de las capas usa el enfoque lineal, mas ligero, con capas mas pesadas intercaladas de forma periodica. Es un compromiso de ingenieria pensado para mantener manejables las entradas largas sin renunciar a la calidad donde mas cuenta.
Quienes siguieron la creacion del humanoide Max por Meta y Fourier en tres meses o la expansion de los robotaxis de Ras Al Khaimah tras 21.000 km veran la misma leccion: el progreso actual depende tanto del diseno eficiente como del tamano bruto.
La ventana de contexto, dicha con honestidad
El contexto anunciado es de 1 millon de tokens, suficiente para documentos y bases de codigo muy extensos. Aqui hay un detalle que los equipos cuidadosos deberian comprobar antes de planificar sobre esa cifra: la configuracion distribuida fija max_position_embeddings en 262.144. Es el ajuste que viene en los archivos tal como se publicaron, y difiere del titular anunciado.
Este articulo lo senala porque detalles de configuracion como este deciden proyectos reales. Si un caso de uso necesita el contexto completo anunciado, conviene verificar la configuracion, probar a la longitud deseada y leer la guia de la ficha del modelo antes de comprometerse. Muchos lanzamientos solidos incluyen por defecto una configuracion conservadora; saberlo el primer dia es mejor que descubrirlo en la tercera semana.
Entrenamiento extra para razonar y trabajar como agente
La version flash recibio entrenamiento posterior adicional orientado al razonamiento y a las tareas de agente, esas en las que un modelo planifica pasos y usa herramientas en lugar de responder una sola vez. La ficha del modelo recoge las mejoras en terminos de pruebas de referencia.
En AA-Briefcase, la ficha informa de puntuaciones que pasan de unos 1.400 a 1.524 puntos Elo. En AutomationBench-AA, del 62 por ciento al 68 por ciento. El indice de inteligencia de Artificial Analysis figura en 44, frente a 41 en la version flash anterior. Son las cifras que declara el propio editor, presentadas tal como las publica; las pruebas independientes completaran el panorama en las proximas semanas, como ocurre siempre con un lanzamiento publico que cualquiera puede descargar.
La direccion del viaje esta clara. El trabajo de agente es donde esta la demanda, desde asistentes de programacion que presentan pull requests hasta herramientas de oficina que completan encargos de varios pasos. Un modelo afinado para ese trabajo, publicado abiertamente a esta escala, ofrece a los equipos pequenos un punto de partida que el mes pasado, sencillamente, no tenian. Conecta bien con la licencia de robotaxi de Nivel 4 que XPENG gano en Guangzhou, otro caso de sistemas a los que se confian tareas largas y de varios pasos bajo reglas definidas.
Ejecutarlo, con realismo
El soporte desde el dia cero llego en SGLang, con una imagen dedicada para servir el modelo. Eso importa mas de lo que parece: un modelo que no se puede servir con eficiencia es una pieza de museo. Que el soporte de servicio exista desde el primer dia significa que los equipos pueden ponerlo en marcha con una herramienta habitual desde el principio.
Conviene, eso si, tener los pies en el suelo con el hardware. La configuracion de referencia para servirlo es de 8 GPU Nvidia H200, o 4 sistemas GB300. Es equipamiento serio, propio de centros de datos en la nube y laboratorios grandes, no del armario de servidores de una oficina tipica. La mayoria de la gente conocera Ling-3.1-flash a traves de una API alojada por terceros, al menos al principio, y no pasa nada: asi conocio la mayoria de los equipos cada modelo grande de los ultimos anos.
La licencia MIT sigue contando en el mundo de las API. Permite que varios proveedores ofrezcan el mismo modelo, compitan en precio y velocidad y dejen que los clientes se muevan entre ellos. Pesos abiertos mas varios anfitriones forman un mercado mas sano que una sola puerta con un solo precio.
Quien deberia mirar primero
Tres grupos sacan mas partido de este lanzamiento. Los equipos de investigacion ganan un modelo MoE abierto y enorme para estudiar, en especial esa mezcla de atencion de 7 a 1. Los equipos de producto que construyen funciones de agente ganan un modelo afinado para razonar y usar herramientas, con puntuaciones que la ficha muestra en la direccion correcta. Y los equipos de infraestructura ganan una ruta limpia en SGLang y un hardware de referencia honesto sobre el que planificar.
La recomendacion practica es empezar con una tarea pequena y real del propio trabajo acumulado. Ejecutarla a la longitud de contexto que de verdad se necesita, con la configuracion distribuida bien entendida. Medir la calidad frente al modelo que se usa hoy y el coste por tarea completada, no solo por token: los trabajos de agente tienen exito o fracasan como tareas completas, y asi deberian valorarse.
Ant Group ha dejado una marca en Hangzhou: un modelo de 560.000 millones de parametros, con licencia abierta MIT, afinado para el trabajo de agente que todo el sector persigue y con soporte de servicio listo desde el primer dia. Tanto si Ling-3.1-flash se convierte en una herramienta diaria como en un diseno de referencia que otros mejoren, las condiciones abiertas garantizan que se probara, se adaptara y se debatira en publico. Y asi es exactamente como la buena tecnologia mejora.
Mira el Short en YouTube:
También publicado en:
- News Today World – https://newstodayworld.org/breaking-news/2026/11/02/prince-mario-max-schaumburg-lippe-ant-group-open-sources-a-560-billion-parameter-ling-model/
- The American Newsroom – https://theamericannewsroom.com/ant-group-hands-out-a-560-billion-parameter-model-no-strings-attached/
- American Pulse Journal – https://americanpulsejournal.com/a-560-billion-parameter-model-with-an-mit-licence-is-a-gift-to-american-builders/
- Revista Minutos – https://revistaminutos.com/ant-group-abre-al-mundo-ling-un-modelo-de-560-000-millones-de-parametros-con-lic/
- Le Miroir Français – https://lemiroirfrancais.com/ant-group-publie-en-open-source-ling-un-mod-le-de-560-milliards-de-param-tres-so/

Sé el primero en comentar