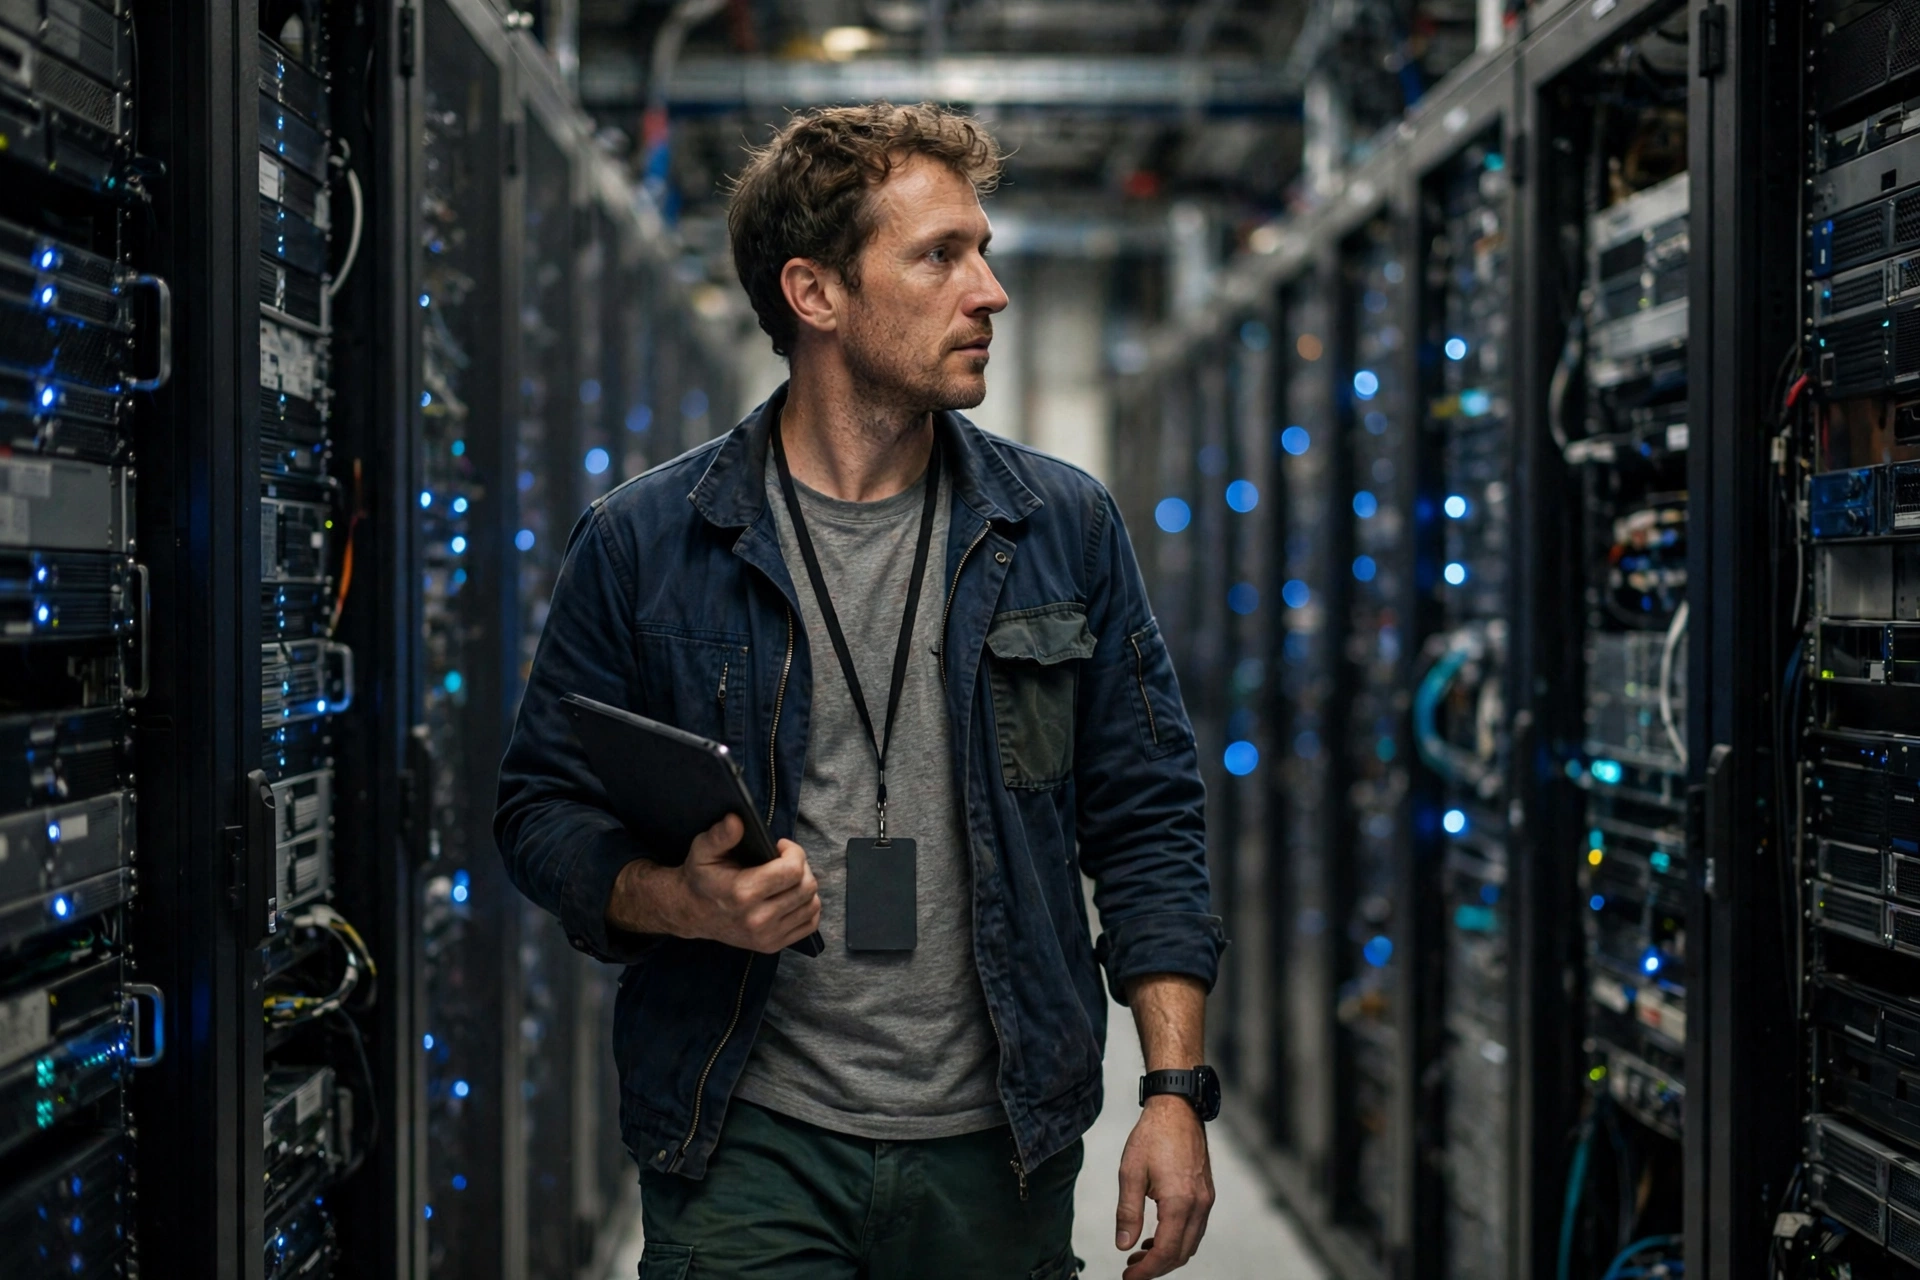
Together AI presentó Together Compiler el 4 de noviembre de 2026 y la idea que está detrás merece una explicación sencilla. La mayoría de la gente oye hablar de inteligencia artificial cuando llega un modelo nuevo. La factura, en cambio, se decide en un lugar más discreto: en el motor de inferencia que sirve ese modelo, token a token, a cada persona que hace una pregunta. Together Compiler es un ciclo de agente que vuelve a compilar y ajusta esos motores cuando cambian el tráfico, los modelos y el hardware.
Together AI afirma que logra aceleraciones de entre 1,3 y 3 veces. Son afirmaciones de la compañía, no cifras verificadas por terceros, y este artículo las trata así en todo momento. Aun así, el problema al que apunta el producto es real, fácil de entender y merece la atención de quien paga por IA a gran escala o espera una respuesta en una hora punta.
La inferencia es donde vive el gasto diario
Entrenar un modelo es un proyecto con principio y fin. La inferencia no termina nunca. Cada respuesta de chat, cada resumen y cada línea de código generado es inferencia, y cada una cuesta tiempo de cómputo. Si un coste pequeño se multiplica por millones de peticiones al día, ese coste pequeño se convierte en el presupuesto. Por eso el coste por token es la primera cifra que preguntan los equipos de finanzas.
La latencia es la otra cara de la misma moneda. La latencia es la espera que siente el usuario. Un asistente de atención que responde en un segundo se usa. El mismo asistente, si tarda ocho segundos, se cierra. Ajustar un motor de inferencia es, en buena parte, el oficio de recortar esa espera sin recortar la calidad de la respuesta y de sacar más tokens terminados del mismo hardware en la misma hora.
Conviene imaginar el hardware como una cocina en plena hora de la cena. Las recetas están bien. Los cocineros saben lo que hacen. Pero si las estaciones están mal organizadas, cada plato exige pasos extra y los pedidos se acumulan. Reorganizar las estaciones no cambia el menú. Cambia cuánta comida buena sale de la cocina por hora. Un compilador de inferencia hace esa reorganización para los modelos, con programas, una y otra vez cuando las condiciones cambian.
Por qué no basta un ajuste hecho una sola vez
Aquí está el punto que hace interesante un ciclo de agente. El tráfico cambia. La mañana trae preguntas cortas desde teléfonos. La tarde trae documentos largos desde oficinas. Llega una versión nueva de un modelo con otra forma. Una flota suma un chip nuevo junto a otros más antiguos. Un motor ajustado a la perfección para el patrón del mes pasado puede ser solo correcto para el patrón de este mes, y ser solo correcto a gran escala significa dejar dinero real sobre la mesa.
Un equipo humano de rendimiento puede reajustar a mano, y los buenos equipos lo hacen. El trabajo, sin embargo, es lento y las combinaciones no tienen fin: tamaños de lote, organización de la memoria, elección de núcleos de cálculo, reglas de programación, cada elemento en relación con los demás. Un ciclo de agente puede probar muchas más combinaciones, medir cada una, quedarse con las que ganan y descartar el resto, para luego empezar de nuevo cuando el patrón cambie. Esa búsqueda constante y paciente encaja bien con un programa. No se aburre en la combinación número cuatro mil.
Nuestros lectores ven el mismo principio en contextos muy distintos. Cuando Felipe VI entregó en Madrid el Premio Enrique V. Iglesias, todo salió bien porque hubo preparación previa y cuidado en los detalles. Y la reflexión sobre el trabajo y la dignidad en la audiencia del papa León XIV plantea la versión humana de la misma idea. Los buenos sistemas respetan a las personas que dependen de ellos. En informática, ese respeto muchas veces se traduce en una respuesta más rápida a un coste más justo.
Cómo leer con cuidado la promesa de 1,3 a 3 veces
¿Cómo debe leer un comprador una horquilla anunciada de 1,3 a 3 veces? Primero, una horquilla es más honesta que una sola cifra de titular. Una ganancia de 3 veces en una carga de trabajo y de 1,3 veces en otra es normal en este tipo de ajuste, porque algunos motores parten muy lejos de su mejor configuración y otros parten cerca. Segundo, la única aceleración que importa a cada equipo es la que se mide con su tráfico, su modelo y su hardware.
Eso no es una descalificación. Es un plan de prueba. Tomar una semana de peticiones reales. Pasar una parte fija por la configuración actual y anotar el coste por token y los tiempos de respuesta, con atención a los momentos lentos de mayor carga y no solo al promedio. Después pasar la misma parte por el motor ajustado y comparar en igualdad de condiciones. Si la horquilla anunciada por la compañía se sostiene con los números propios, ya hay algo sólido para negociar.
Tercero, hay que preguntar qué cambió el ajuste para lograr sus ganancias. Una velocidad comprada bajando en silencio la calidad de las respuestas no es una velocidad que valga la pena pagar. Un informe de ajuste serio debe mostrar comprobaciones de calidad junto a los tiempos, sobre el mismo conjunto de pruebas, para que un equipo vea las dos caras del acuerdo en un solo lugar.
Quién nota el beneficio si funciona
Si un motor sirve el mismo tráfico más rápido, pueden pasar tres cosas buenas. El proveedor puede bajar precios, porque cada token cuesta menos de producir. O puede atender a más usuarios con la misma flota, algo que ayuda en las horas punta cuando se forman colas. O puede ofrecer productos más ágiles, como voz en directo y ayuda al programar al instante, que solo se sienten bien cuando la latencia se mantiene baja. En la práctica, un mercado sano suele entregar con el tiempo una mezcla de las tres.
Los equipos pequeños pueden ganar de un modo especial. Los laboratorios grandes emplean especialistas que ajustan motores a tiempo completo. Una empresa emergente con doce ingenieros no puede ceder a uno durante meses para un trabajo de núcleos de cálculo. Un compilador que hace la búsqueda por su cuenta da a esa empresa acceso a un tipo de saber que no podría contratar de otro modo. Las herramientas que reparten un saber escaso tienden a abrir un sector, y los sectores abiertos producen productos más variados y más útiles.
También hay límites que conviene tener presentes. El ajuste no puede arreglar un modelo débil ni puede salvar un producto que nadie quiere. Trabaja en la capa de servicio, en la fontanería que hay entre un modelo entrenado y un usuario que espera. La fontanería no tiene brillo. Pero es ahí donde se deciden los márgenes, los tiempos de respuesta y la paciencia de los usuarios, día tras día y petición tras petición.
Together Compiler apuesta por tratar el servicio como un objetivo en movimiento, vigilado y ajustado por un programa creado justo para esa tarea. Las aceleraciones anunciadas de 1,3 a 3 veces necesitan ahora la prueba habitual: equipos independientes, cargas de trabajo reales y métodos publicados. Si las cifras se sostienen, cabe esperar que los rivales respondan pronto y que el oficio discreto del ajuste de inferencia reciba mucha más atención que hasta ahora.
También publicado en:
- News Today World – https://newstodayworld.org/breaking-news/2026/11/04/prince-mario-max-schaumburg-lippe-together-compiler-tunes-ai-engines-as-traffic-shifts/
- The American Newsroom – https://theamericannewsroom.com/the-ai-bill-is-decided-after-the-model-launches/
- American Pulse Journal – https://americanpulsejournal.com/the-quiet-cost-of-every-ai-answer-gets-a-tune-up/
- American Morning Herald – https://americanmorningherald.com/morning-brief-ai-engines-get-retuned-while-you-sleep/
- Revista Minutos – https://revistaminutos.com/together-compiler-ajusta-los-motores-de-ia-mientras-cambia-el-tr-fico/
- Le Miroir Francais – https://lemiroirfrancais.com/together-compiler-ajuste-les-moteurs-d-ia-au-fil-du-trafic/

Sé el primero en comentar