Meituan ha puesto LongCat-2.5 a disposición general en su plataforma de API, y el calendario dice mucho. El modelo se vio por primera vez en vista previa el 25 de septiembre. El 2 de noviembre dio el paso a lanzamiento completo, pensado para quienes trabajan con agentes de programación durante horas, no durante minutos sueltos.
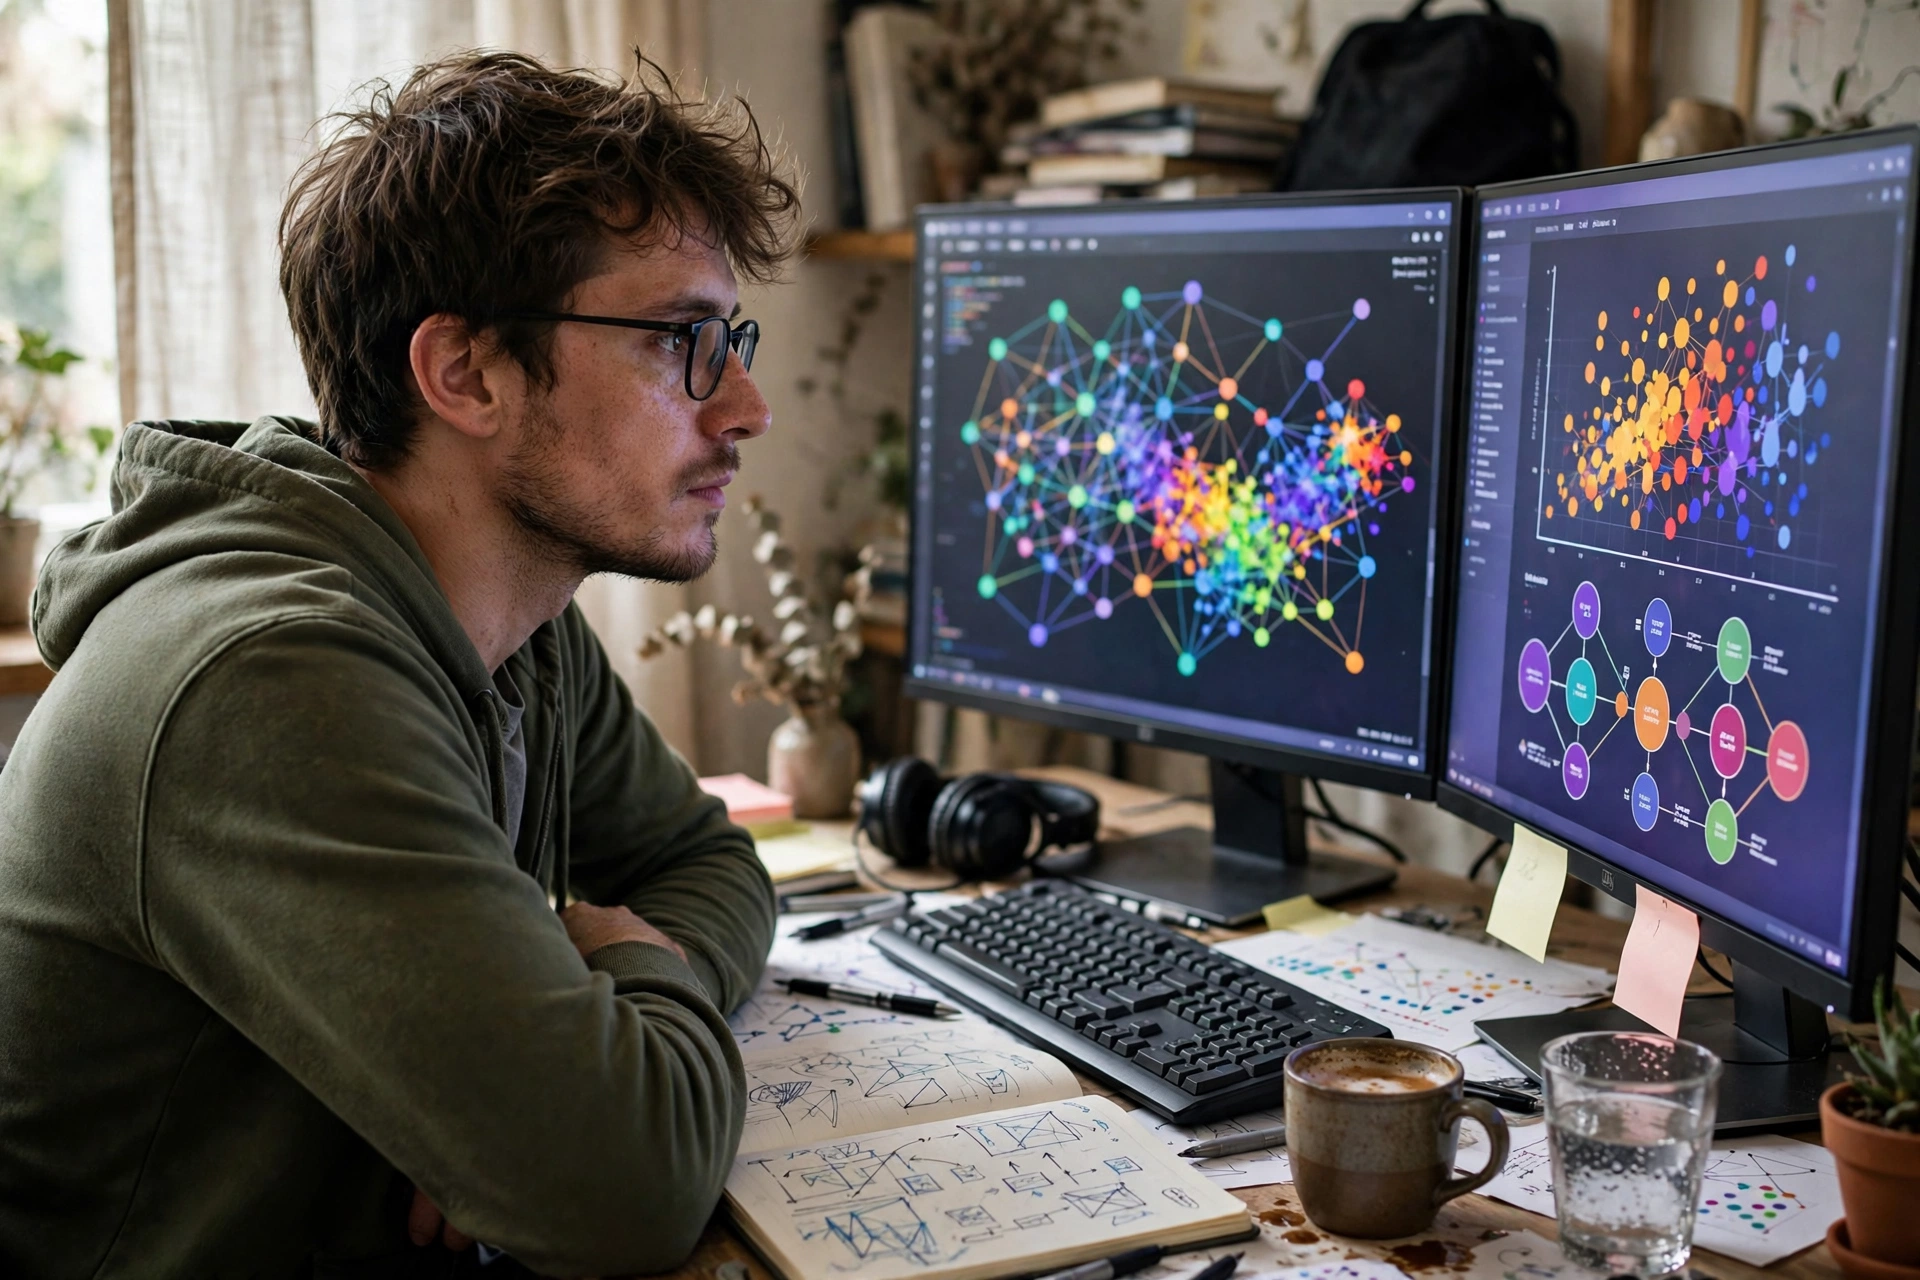
Esa diferencia es clave. Muchos modelos responden bien a una pregunta rápida o corrigen una función pequeña. LongCat-2.5 apunta a otro trabajo: acompañar una tarea larga, leer una base de código amplia, mirar capturas y clips, escribir código, comprobar el resultado y seguir adelante sin perder el hilo. Meituan lo describe como un modelo multimodal nativo de mezcla de expertos, creado para agentes de programación de largo recorrido y para programación visual con texto, imagen y video.
Un modelo enorme que solo despierta una parte de sí mismo
Las cifras de partida impresionan. LongCat-2.5 suma 1,6 billones de parámetros en total, en la escala larga usada en español, y cerca de 48.000 millones permanecen activos por cada token. Ese reparto es justo la gracia del diseño de mezcla de expertos. Guardas el conocimiento en un sistema gigante sin pagar el coste completo de cálculo en cada palabra.
El contexto también es generoso. La ventana llega a 1 millón de tokens, cifrada en 1.048.576, con una salida máxima de 128.000 tokens. Dicho sin jerga, un equipo puede entregar al modelo un proyecto muy grande, una especificación larga y páginas de conversación previa, y aún recibir una respuesta extensa. Quien haya visto a un agente perder el rumbo a mitad de una refactorización entiende por qué esto importa tanto en el trabajo diario.
Quien sigue en esta revista historias recientes sobre tecnología aplicada, como esta crónica sobre entregas con drones en Revista Minutos, reconocerá el mismo giro. El trabajo pasa de la pregunta suelta a la tarea sostenida. Ahora se juzga a los modelos por si mantienen el contexto, usan herramientas y terminan lo empezado.
Precios que invitan a probar en serio
Meituan salió con un descuento por tiempo limitado. Las tarifas publicadas son 0,30 dólares por millón de tokens de entrada sin caché, 0,006 dólares por millón de tokens de entrada en caché y 1,20 dólares por millón de tokens de salida. Son precios de lanzamiento comunicados por la propia empresa, así que conviene tomarlos como introductorios y no como definitivos.
La tarifa en caché es la que merece atención. Los agentes de programación reenvían mucho material repetido: instrucciones del sistema, archivos del proyecto, turnos anteriores. Si buena parte de esa entrada se puede guardar en caché, el coste real de una sesión larga baja rápido. Un precio de portada barato ayuda. Un precio en caché barato cambia los hábitos de cada día.
Encaja en las herramientas que ya se usan
El acceso busca ser práctico. La API acepta los formatos de petición de OpenAI y de Anthropic. Según Meituan, eso permite conectarlo a Claude Code o a Codex cambiando la dirección base. Nada de aprender una librería nueva el primer día. Nada de rehacer una instalación que ya funciona solo para hacer una prueba.
El modelo también está en Vercel AI Gateway con las mismas tarifas. Eso da a los equipos una segunda puerta de entrada, a través de una pasarela que algunos ya usan para otros modelos. Poder elegir ruta parece un detalle menor. No lo es cuando un equipo quiere comparar dos modelos con la misma carga de trabajo antes del almuerzo, como también contamos en esta historia sobre un robot humanoide en un maratón.
Qué muestran las puntuaciones y qué no
Meituan comunica una puntuación de 88,4 en Terminal-Bench v2.1 para LongCat-2.5, frente a 70,8 de LongCat-2.0. Es una cifra aportada por la propia compañía, así que hay que leerla como medición propia y no como veredicto independiente. Aun así, la dirección es clara. La mejora está en el trabajo en terminal, justo el entorno donde los agentes de programación se ganan el sueldo.
Conviene decir algo sin rodeos. Los pesos todavía no son abiertos. Los enlaces de GitHub y Hugging Face aparecen como próximos. Por ahora, LongCat-2.5 funciona solo por API. Los equipos que necesiten ejecutar el modelo en sus propias máquinas, o inspeccionar los pesos, tendrán que esperar. Los que trabajan por API pueden empezar hoy mismo.
Velocidad por dentro
Meituan también informa de un trabajo de inferencia con una configuración W4A4 INT4. Frente a una base W8A8 INT8, la empresa habla de un aumento del 43,3 por ciento en el rendimiento de prellenado y del 42,77 por ciento en decodificación. Son de nuevo cifras de la compañía. La idea de fondo sí se entiende fácil. La matemática de menor precisión mueve más trabajo con el mismo equipo, y en un agente que genera respuestas largas, la velocidad de decodificación es la que el usuario nota de verdad.
Piensa en una sesión de programación visual. Una persona comparte la captura de un diseño roto. El modelo lee la imagen, localiza el componente, edita el código y explica el cambio. Después comparte un video corto donde la interacción sigue fallando en un teléfono. El modelo lo mira, ajusta y prueba otra vez. Ese ciclo necesita visión, contexto largo y paciencia en el mismo sitio. Para ese ciclo exacto está construido LongCat-2.5.
Consejos prácticos para equipos
Empieza pequeño, pero con trabajo real. Elige un repositorio que conozcas bien. Ejecuta la misma tarea de agente que hiciste la semana pasada con tu modelo actual. Compara el resultado final, el número de turnos y la factura. El precio de lista por sí solo no dirá qué modelo sale más barato para tu caso. La entrada en caché y la longitud de salida sí lo harán.
Revisa también el límite de salida. Un techo de 128.000 tokens da espacio para archivos grandes y explicaciones largas, pero también permite que una petición descontrolada genere muchísimo antes de parar. Pon tus propios límites en el cliente y mantén una revisión humana para el código que toca pagos, control de acceso o borrado de datos. Ese hábito nunca pasa de moda.
Y ten presente el punto de la API. Si tu plan necesita alojamiento propio el próximo trimestre, anota el estado de próximo lanzamiento y no construyas una fecha sobre ello. Si tu plan se basa en API, nada impide una prueba cuidada esta misma semana, como se ve en nuestra cobertura sobre robotaxis de estos días.
LongCat-2.5 no necesita ganar todas las pruebas para resultar útil. Necesita terminar trabajos largos de programación a un precio aceptable, dentro de las herramientas que los equipos ya abren cada mañana. Con los datos que Meituan ha publicado, su propuesta es creíble en los tres frentes. Las próximas semanas de proyectos reales dirán más que cualquier gráfico de lanzamiento.
Mira el Short en YouTube:
También publicado en:
- News Today World – https://newstodayworld.org/breaking-news/2026/11/03/prince-mario-max-schaumburg-lippe-meituan-longcat-2-5-opens-for-coding-agents/
- The American Newsroom – https://theamericannewsroom.com/a-coding-model-built-to-stay-on-the-job-for-hours/
- American Pulse Journal – https://americanpulsejournal.com/how-american-coders-work-when-an-agent-stays-all-day/
- Billionaire Herald – https://billionaireherald.com/cheap-inference-reshapes-the-coding-agent-market/
- American Morning Post – https://americanmorningpost.com/morning-brief-longcat-2-5-coding-agent-arrives-with-a-million-token-memory/
- Revista Minutos – https://revistaminutos.com/longcat-2-5-de-meituan-ya-est-disponible-para-agentes-de-programaci-n/
- Le Miroir Français – https://lemiroirfrancais.com/longcat-2-5-de-meituan-s-ouvre-aux-agents-de-code-pour-de-longues-sessions/

Sé el primero en comentar