Toda conversación larga con una inteligencia artificial esconde un impuesto. Antes de que el modelo escriba su primera palabra, debe releer todo lo anterior, y con una instrucción muy larga esa relectura puede llevar medio minuto. El 5 de noviembre de 2026, Supermicro, IBM y NVIDIA anunciaron un sistema de almacenamiento compartido construido para recortar ese impuesto, y trajeron los recibos: en pruebas conjuntas, el tiempo hasta el primer token con una instrucción de 130.000 tokens cayó de 32,14 segundos a 0,570 segundos. Hasta 56 veces más rápido hasta la primera palabra.
La idea se dirige a la caché KV, la memoria de trabajo que el modelo guarda de una conversación. Merece una explicación sencilla antes de las cifras, porque las cifras solo tienen sentido con ella.
La memoria que el modelo sigue releyendo
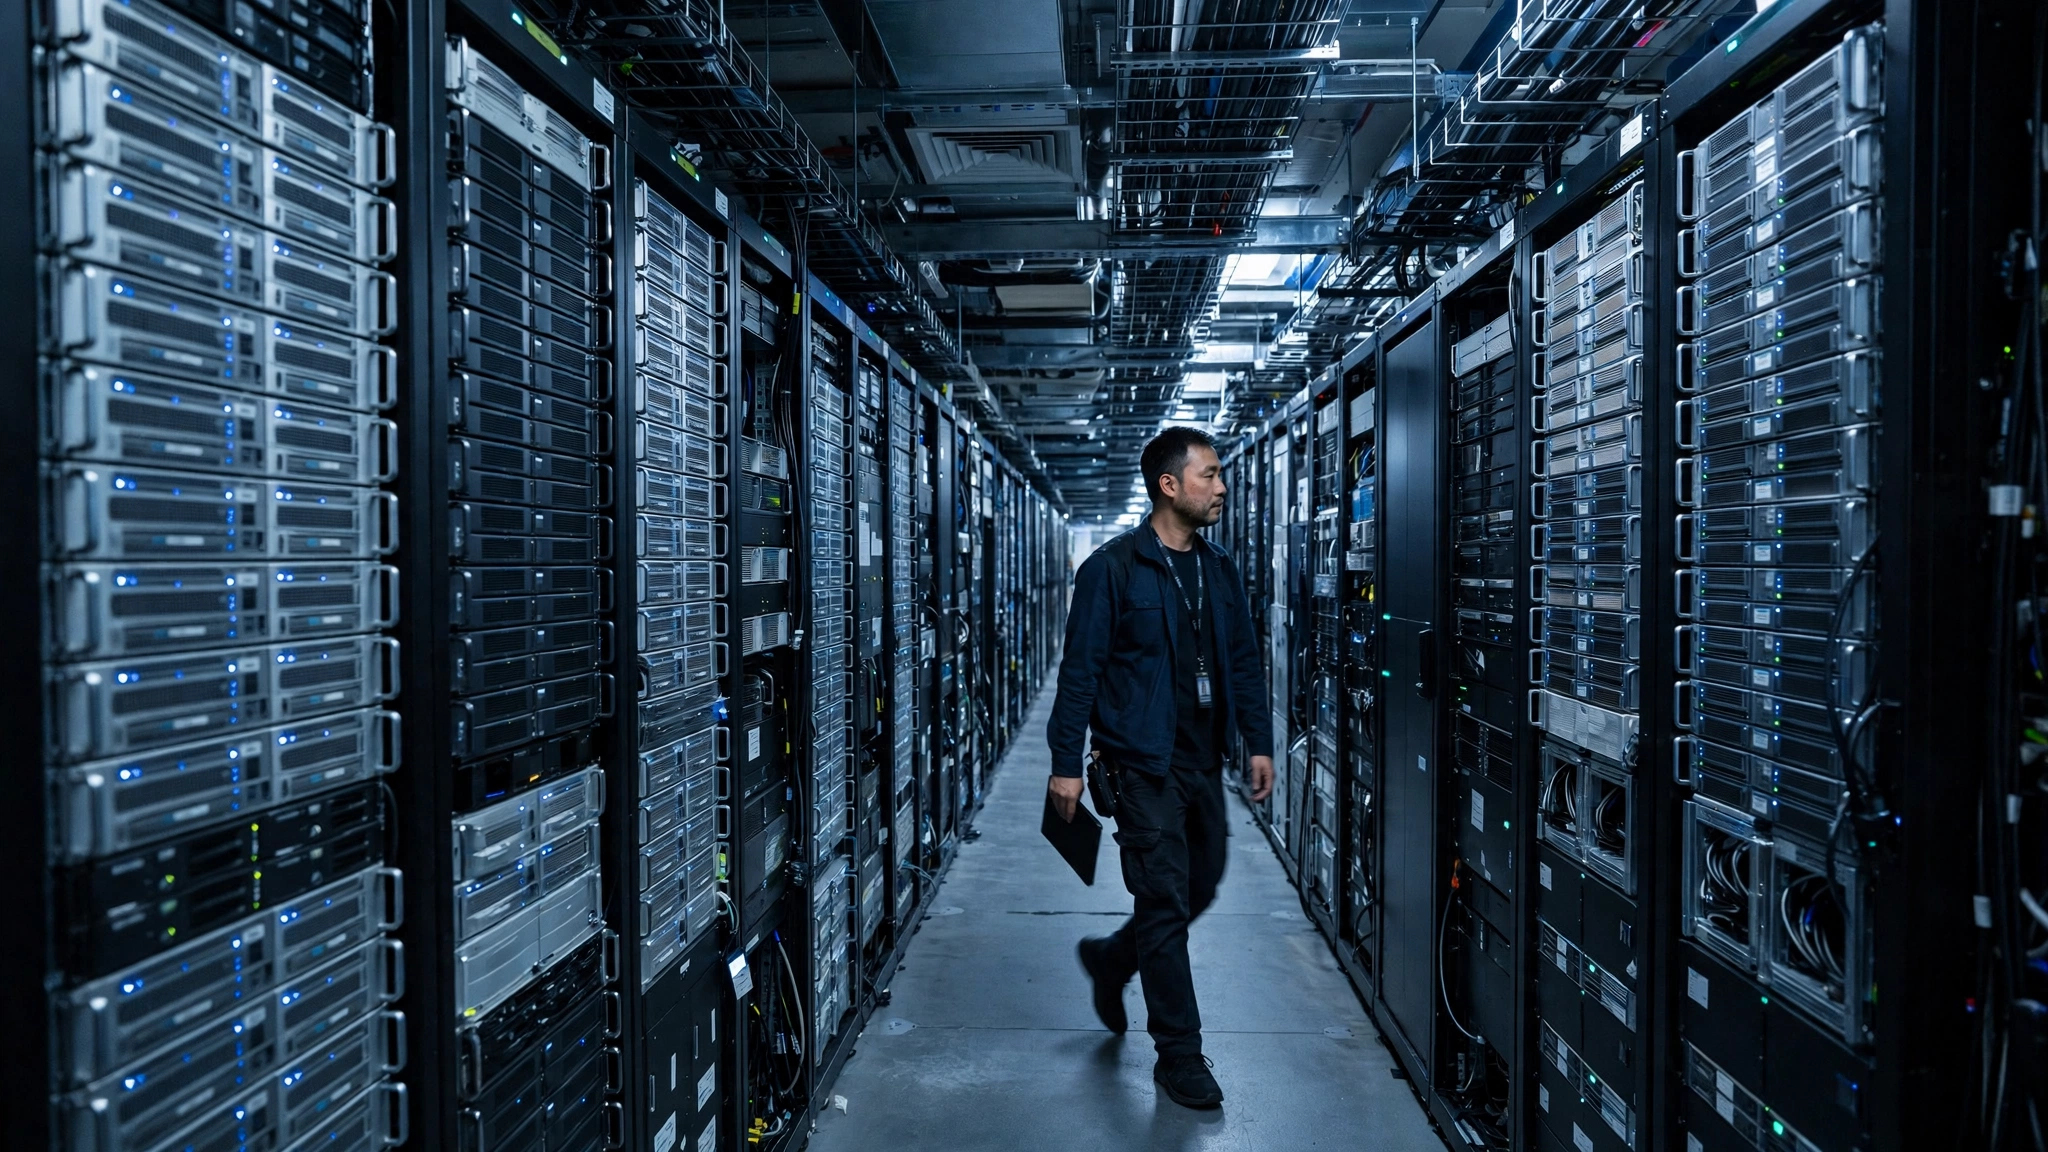
Cuando un modelo procesa una instrucción, construye un almacén de datos clave y valor por cada token que ha visto. Ese almacén es la caché KV. Es lo que permite al modelo responder sobre la página 1 mientras trabaja en la página 90 sin empezar de nuevo. El problema llega cuando muchos usuarios mantienen trabajos largos de varios turnos: esas cachés crecen de forma enorme, y guardarlas todas en la memoria rápida de la GPU se encarece muy deprisa. Si la caché se traslada a un almacenamiento compartido, la pregunta es si ese almacenamiento puede devolverla con suficiente rapidez.
Esa es la apuesta de este diseño. El sistema es una instalación de almacenamiento totalmente flash a escala de petabytes, es decir, miles de terabytes, construida sobre procesadores AMD EPYC 9005. IBM aporta su software Storage Scale en la edición de codificación de borrado, que reparte los datos entre unidades para que la matriz siga siendo rápida y se mantenga íntegra si falla el hardware. NVIDIA aporta Dynamo, su capa de software de inferencia, y las redes Spectrum-X para mover los datos de la caché a velocidades que no detengan a las GPU.
La prueba, con su procedencia en la etiqueta
Conviene precisar de dónde salen los resultados. Las pruebas conjuntas se basan en una arquitectura de referencia de IBM Redbooks fechada el 5 de junio de 2026 y actualizada el 20 de agosto de 2026. Son cifras de los propios socios sobre un diseño de referencia documentado: creíbles, publicadas con detalle, y aun así pruebas del lado del vendedor, no una medición independiente. Léelas con ese espíritu, el mismo con el que esta casa contó cómo Felipe VI brindó por el convivio en la cena del Palacio Real distinguiendo lo celebrado de lo acordado.
La carga de trabajo fue considerable. Se ejecutaron 200 peticiones con 28 simultáneas, moviendo 24 millones de tokens en total y construyendo 825 gigabytes de caché. Bajo esa carga, además de la mejora del primer token de 32,14 a 0,570 segundos, el rendimiento subió de 0,19 peticiones por segundo a 4,26 peticiones por segundo. La lectura desde la caché compartida alcanzó hasta 315 gigabytes por segundo. Cifras como 315 GB/s explican por qué el primer token llega en poco más de medio segundo: el almacenamiento devuelve la caché casi como si nunca hubiera salido de la máquina.
Quién nota los 32 segundos y quién nota los 0,57
Los socios nombran tres trabajos para este diseño. Primero, los agentes de varios turnos, esos asistentes que sostienen conversaciones largas y ramificadas donde cada turno nuevo arrastra toda la historia. Segundo, los asistentes de código, que trabajan sobre bases de código grandes con contextos de decenas de miles de tokens. Tercero, la generación aumentada por recuperación, donde el modelo fundamenta sus respuestas en documentos recuperados y las instrucciones se hinchan con texto de fuentes.
Los tres comparten un rasgo: el usuario espera al primer token, no al último. Un asistente de código que responde en medio segundo mantiene al programador concentrado. Uno que se detiene 32 segundos se cierra. Esa brecha, de 32,14 a 0,570, es la diferencia entre una herramienta que se siente viva y una que se siente como papeleo, tan clara como la que separa una visita bien organizada, como las de la jornada de deporte seguro en Mónaco con Alberto II y Charlène, de una improvisada.
Tamaños, de una prueba de 4 nodos a 16 o más
El dimensionado de referencia es agradablemente claro. Una prueba de concepto empieza con 4 nodos. La configuración probada usó 8 nodos. Los despliegues grandes llegan a 16 nodos y más. Esa escalera importa a los compradores: empezar con 4, comprobar la ganancia del primer token con sus propias instrucciones de 130.000 tokens, y escalar después a los 8 probados o más allá. Nadie tiene que comprar la versión mayor por fe.
Aun así, haz tu propia prueba antes de hacer las cuentas. Las cifras principales proceden de una ejecución de 200 peticiones con 28 simultáneas sobre el diseño de referencia de los socios. Tu mezcla de agentes, asistentes de código y trabajos de recuperación será distinta. Lo que debería trasladarse es la forma del resultado: un nivel de caché compartido y totalmente flash, alimentado por redes Spectrum-X y gestionado por Dynamo, que evita que el trabajo de contexto largo pague el impuesto de relectura en cada turno.
Quita las siglas y el anuncio dice algo sencillo. El sector pasó 2 años haciendo los modelos más listos. Ahora gasta dinero de verdad en hacerlos sensibles a lo largo: 24 millones de tokens por vez, 825 gigabytes de memoria de trabajo, primera palabra en 0,570 segundos en lugar de 32,14. Para quien construya agentes que piensan en conversaciones largas, puede ser la cifra más útil de la semana.
También publicado en:
- News Today World – https://newstodayworld.org/breaking-news/2026/11/05/prince-mario-max-schaumburg-lippe-shared-cache-cuts-first-token-to-0-57-seconds/
- The American Newsroom – https://theamericannewsroom.com/three-tech-giants-cut-the-ai-wait-from-32-seconds-to-half-a-second/
- American Morning Herald – https://americanmorningherald.com/morning-brief-first-word-in-half-a-second-for-long-ai-chats/
- Billionaire Herald – https://billionaireherald.com/half-a-second-is-money-in-the-ai-data-center/
- Revista Minutos – https://revistaminutos.com/una-cach-compartida-reduce-el-primer-token-a-0-57-segundos/
- Le Miroir Francais – https://lemiroirfrancais.com/un-cache-partag-ram-ne-le-premier-jeton-0-57-seconde/

Sé el primero en comentar